机器学习方法分类
- 监督学习
- 无监督学习
线性的回归和分类问题
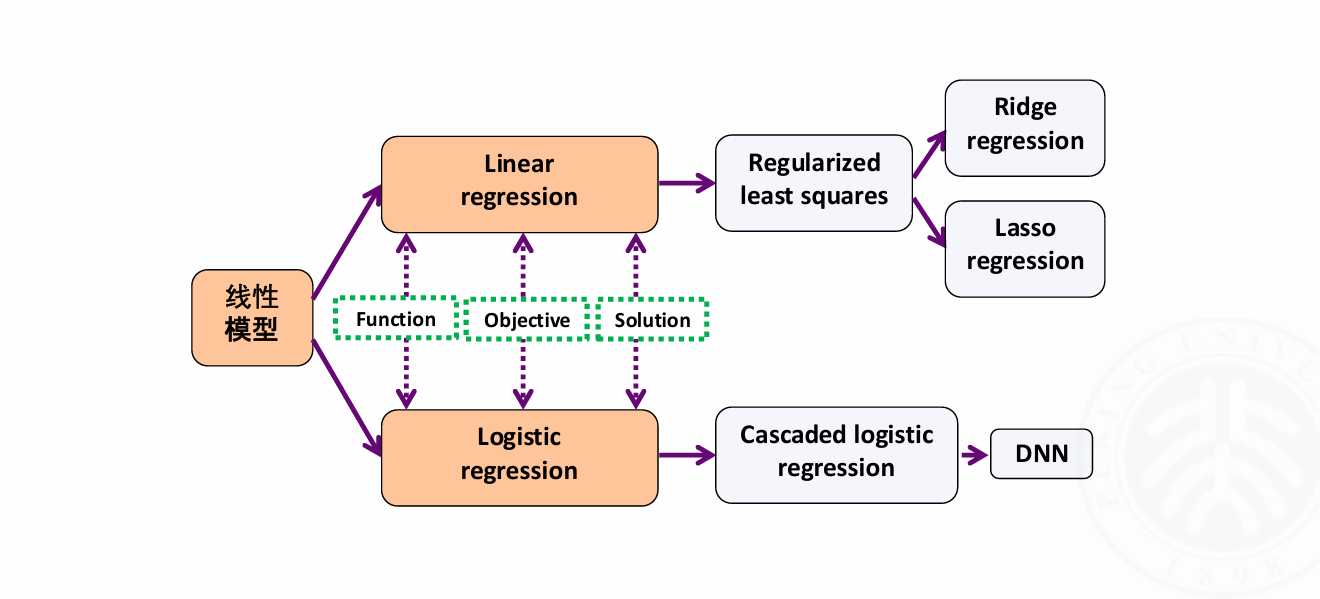
- 线性回归使用均方误差MSE(最大似然估计)
$$ \arg\min_f \mathbb{E}[(fX - Y)^2] $$
- 最小二乘估计可以得到闭式解(前提是X^T X可逆)
$$ \hat{\beta} = (X^T X)^{-1} X^T y $$
- 理论上来说,只要数据量比特征值多就可以求解析解,但是难求
- 所以实践常采用梯度下降或正则化的方法
梯度下降
- 原理:最小二乘法的目标函数是一个关于 𝜷 的二次函数
$$x^{(k+1)} = x^{(k)} - \eta,\nabla f\big(x^{(k)}\big)$$
- $\eta$ 是超参数
正则化方法
说实话我对先验后验不是很理解
贝叶斯学派做了一种抽象,他假定参数作为一个随机变量,服从某个先验的分布,作为一种信念。
lasso回归,拉普拉斯先验分布,L1正则化(稀疏解)
岭回归,高斯先验分布,L2正则化
逻辑回归
我觉得这个算大标题是对的
第一个关键点是sigmoid函数(将分数平滑的压缩到0-1之间,解释为概率)
使用二元交叉熵损失(对于二分类函数)
- 原因包括数值上梯度等于误差 梯度大小与误差成正比
- 减少梯度消失的现象
多元问题
然后SoftMax函数(归一化函数)
$$ \sigma(x) = \frac{1}{1 + e^{-x}}\ \text{softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}}, \qquad i = 1, 2, \dots, K $$